Nerdearla 2026: un agente de viajes con MCP Toolbox y ADK

El miércoles 23 de septiembre di un workshop en Nerdearla 2026, en Buenos Aires: "Crea un agente de viajes con MCP y el Kit de desarrollo de agentes (ADK)". Una hora, sala de workshops presenciales, gente con la notebook abierta y además gente siguiéndolo online. O sea, el escenario ideal para que los dioses de la demo hagan de las suyas.
Ese mismo día había más workshops de ADK a cargo de otros GDEs, así que quise ir por otro lado: menos framework y más de lo que pasa alrededor del agente. Cómo le das acceso a datos reales sin que el agente sepa nada de SQL, y cómo después esas mismas tools las usan varios clientes sin tocar nada.
Todo el material está en github.com/nbellocam/travel-agent y el video quedó grabado:
La pregunta
La slide que abría todo era una sola pregunta: "¿Qué hoteles hay en Mendoza?".
Parece algo simple, pero un modelo solo no la puede contestar bien. Puede tirarte nombres de hoteles que conoce, pero no sabe si hoy hay disponibilidad, a qué precio, ni si ese hotel sigue existiendo. Esa información vive en una base de datos, y la pregunta interesante es cómo se la das al agente.
El workshop está basado en el codelab oficial de Google, Build a Travel Agent using MCP Toolbox for Databases and ADK. Lo actualicé a septiembre de 2026 (versiones, herramientas y varios errores que el original todavía no contempla) y cambié los hoteles suizos por 32 hoteles de Argentina, Uruguay y Chile. Sí, agregar una columna country a una tabla fue mi gran aporte creativo. Uno se entretiene con poco.
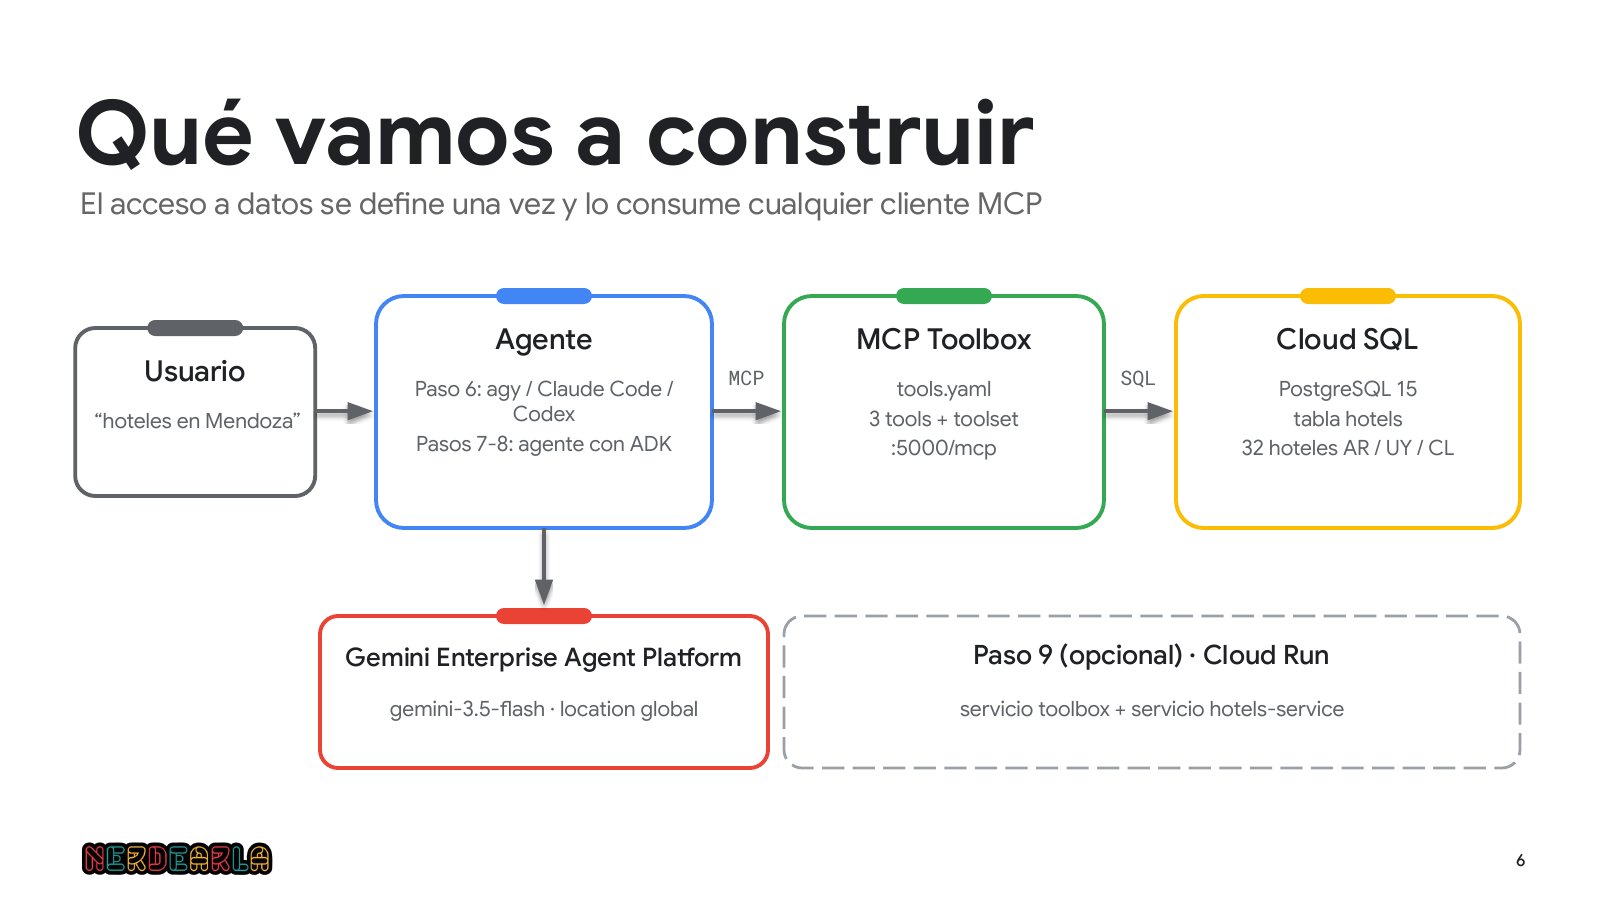
Las piezas son cuatro:
- Cloud SQL para PostgreSQL con la tabla
hotels. - MCP Toolbox for Databases, un servidor open source que expone queries SQL como tools MCP.
- Un CLI con agente (Antigravity CLI, Claude Code o Codex) consumiendo esas tools sin escribir código.
- Un agente propio con ADK en Python, usando las mismas tools, y opcionalmente deployado en Cloud Run.
El agente no sabe SQL
Si había que quedarse con una sola idea, era esta. Al final del workshop, el agent.py queda así:
toolbox = ToolboxSyncClient(TOOLBOX_URL)
tools = toolbox.load_toolset('my_first_toolset')

root_agent = Agent(
    name='hotel_agent',
    model='gemini-3.5-flash',
    instruction=(
        'You are a helpful agent who can answer user questions about hotels in '
        'Argentina, Uruguay and Chile. You can search by hotel name, by city or '
        'by country. Always use the tools to answer; never invent hotels. '
        'Answer in the same language the user writes in.'
    ),
    tools=tools,
)
Buscá una query, una credencial o un driver de Postgres: no hay. Todo eso vive del otro lado del Toolbox, en un tools.yaml.
En un sistema real no vas a tener un agente sino varios, y todos van a querer hablar con la misma base. Si cada uno se arma su propio acceso a datos, volvemos a lo de siempre: lógica duplicada, credenciales desparramadas y cualquier cambio te obliga a redeployar todo. Poner un servidor en el medio es lo que hacemos hace años con cualquier API; la diferencia acá es que ese servidor habla MCP.
El tools.yaml es el contrato
El Toolbox ya viene hecho. Vos no programás el servidor, solo lo configurás. El archivo tiene tres tipos de bloque: la fuente de datos, las tools y los toolsets.
kind: source
name: my-cloud-sql-source
type: cloud-sql-postgres
project: YOUR_PROJECT_ID
region: us-central1
instance: hoteldb-instance
database: postgres
user: postgres
password: postgres
---
kind: tool
name: search-hotels-by-location
type: postgres-sql
source: my-cloud-sql-source
description: Search for hotels based on location (city). Result is sorted by price from least to most expensive.
parameters:
  - name: location
    type: string
    description: The city where the hotel is located, for example 'Mendoza' or 'Montevideo'.
statement: |
  SELECT *
  FROM hotels
  WHERE location ILIKE '%' || $1 || '%'
  ORDER BY
    CASE price_tier
      WHEN 'Midscale' THEN 1
      WHEN 'Upper Midscale' THEN 2
      WHEN 'Upscale' THEN 3
      WHEN 'Upper Upscale' THEN 4
      WHEN 'Luxury' THEN 5
      ELSE 99
    END;
---
kind: toolset
name: my_first_toolset
tools:
  - search-hotels-by-name
  - search-hotels-by-location
  - search-hotels-by-country
Sí, la password es postgres. En el workshop lo dije en voz alta: no hagan eso. En Cloud Run el archivo entero va como secreto en Secret Manager, y en un caso real el usuario de base debería tener solo permisos de SELECT.
El source cloud-sql-postgres resuelve la conexión a través de la API de Cloud SQL con tus credenciales (ADC), así que no hace falta abrir IPs ni pelearse con la red. Y el mismo formato sirve para BigQuery, AlloyDB, Spanner, MySQL, SQLite, Firestore, Neo4j y bastantes más. Cambia el source, el resto queda igual.
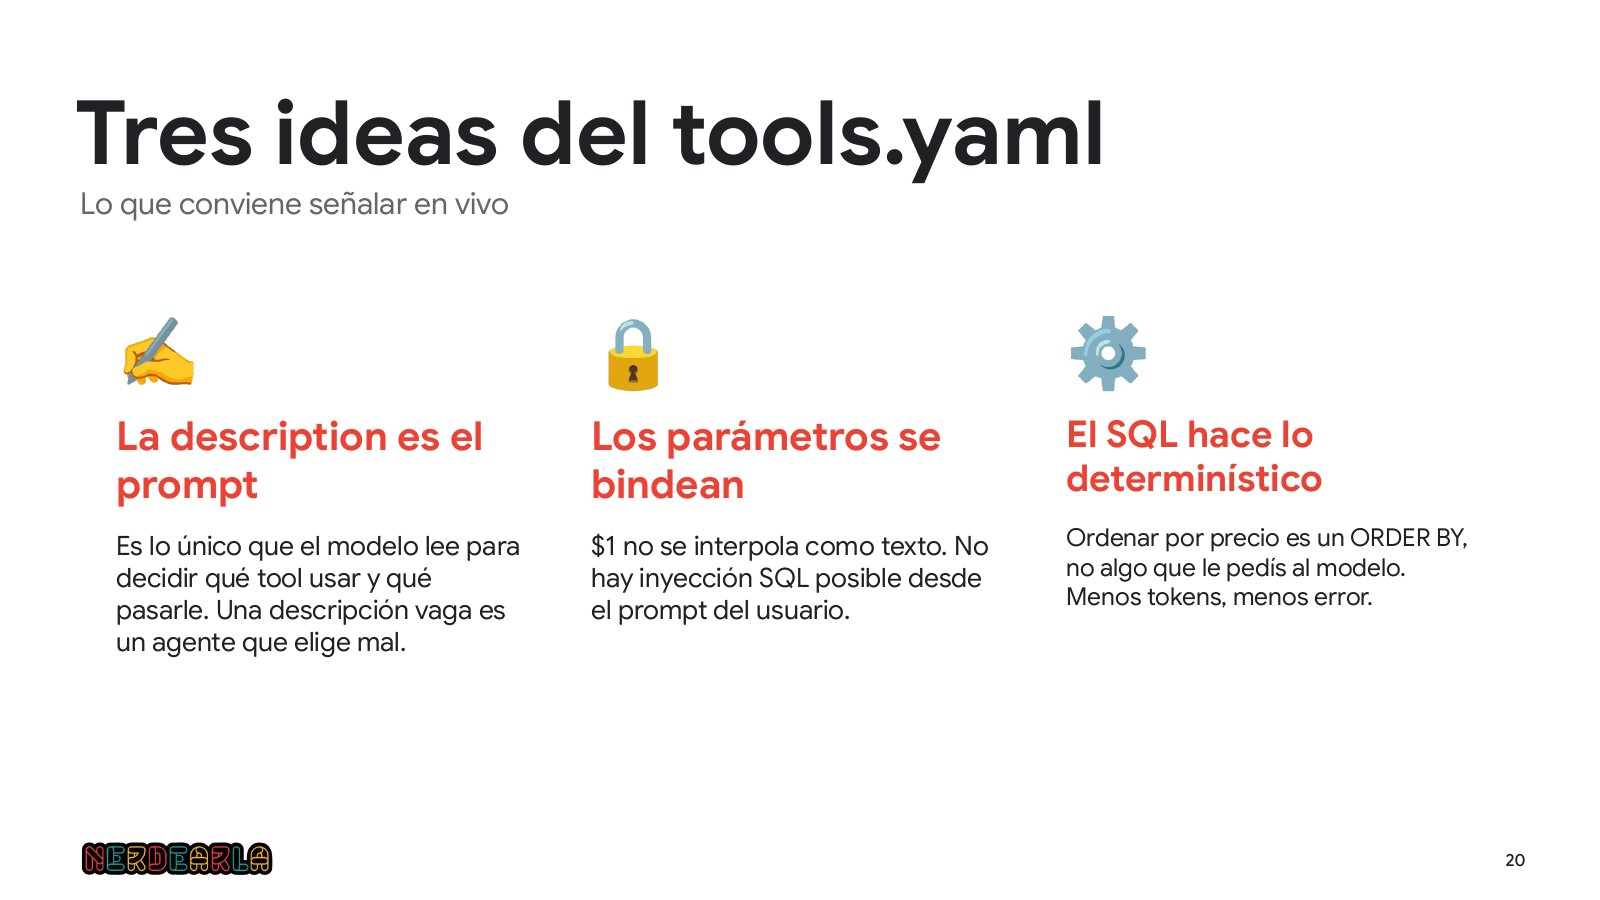
De ese YAML salen tres ideas que para mí valen más que las herramientas en sí, que dentro de un año seguramente sean otras.
La description es el prompt
El modelo decide qué tool usar leyendo solo el nombre, la description y los parámetros. O sea, eso que parece documentación en realidad lo lee el modelo, y funciona como prompt. Si es muy genérica, el modelo la va a usar cuando no corresponde; si es muy específica o ambigua, no la va a enganchar nunca.
La tool que agregué, search-hotels-by-country, lo muestra bien:
description: Search for hotels in a country. Use it when the user asks about
  a whole country instead of a city, for example 'hotels in Chile'.
  Result is sorted by city and then by price.
Esa segunda oración está ahí para desambiguar contra search-hotels-by-location. Sin ella, ante "¿qué opciones tengo en Uruguay?" el modelo podía intentar buscar "Uruguay" como ciudad. Si dos tools se parecen mucho, el modelo se confunde; o escribís descripciones que no se pisen, o las unís en una sola con más parámetros.
Los parámetros se bindean, no se interpolan
El $1 es un parámetro bindeado; acá no se concatena ningún string. El usuario puede escribir lo que quiera en el chat y a Postgres le llega siempre como valor, así que por ese lado no hay SQL injection.
Para mí esto es lo que separa este enfoque de text-to-SQL. Dejar que el modelo arme la query sirve para explorar datos, pero en producción abre una superficie de riesgo enorme. Con queries fijas sabés exactamente qué se puede ejecutar, y el resultado es reproducible.
El SQL hace el trabajo determinístico
El ordenamiento por precio lo resuelve un ORDER BY CASE; no se lo pido al modelo. Gasto menos tokens, hay menos chance de que se equivoque y el resultado es siempre el mismo. Lo mismo corre para lo que devolvés: el ejemplo hace SELECT * por simplicidad, pero en un caso real devolvés solo las columnas que el agente necesita y le ponés un LIMIT. Todo lo que devuelve la query va al contexto del modelo, y miles de filas ahí adentro salen caras y lentas.
En la demo apareció algo que no tenía previsto: la columna booked es de tipo BIT, y el Toolbox la serializa como {"Bytes":"gA==","Len":1,"Valid":true}. El modelo se las arregla, pero si diseñás la tabla sabiendo que la va a leer un agente, un BOOLEAN es mucho más claro. Al final el esquema también termina siendo parte del prompt.
Probar sin agente
Antes de meter cualquier modelo en el medio, el Toolbox tiene una UI para probar las tools directamente:
./toolbox --config "tools.yaml" --ui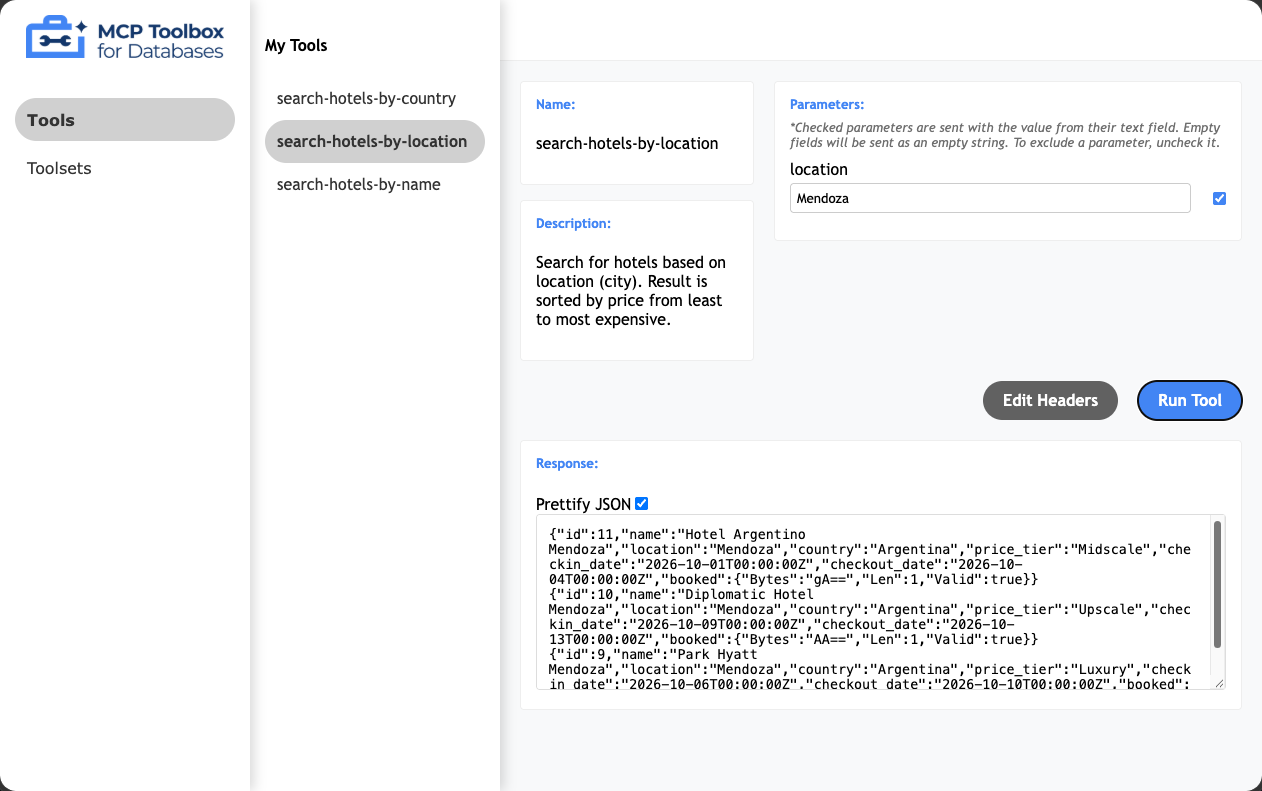
Elegís la tool, le pasás Mendoza y ves el JSON crudo. Me gusta porque te separa los problemas: si acá el resultado ya está mal, tenés que revisar la query y el agente todavía ni entró en juego. En producción no la vas a levantar, pero para desarrollo es la forma más rápida de validar el contrato.
Mismo servidor, tres clientes
Con el Toolbox corriendo, lo primero que hicimos fue conectarlo a un CLI con agente, sin escribir código. Gemini CLI se retiró en junio de este año, así que el paso está reescrito para Antigravity CLI, con Claude Code y Codex como alternativas:
# Antigravity CLI
agy mcp add MCPToolbox http://127.0.0.1:5000/mcp

# Claude Code
claude mcp add --transport http MCPToolbox http://127.0.0.1:5000/mcp

# Codex
codex mcp add MCPToolbox --url http://127.0.0.1:5000/mcp
En vivo lo hice con agy: le pregunté por hoteles en Mendoza, eligió search-hotels-by-location, me pidió permiso para ejecutarla y armó la respuesta con los datos de la base.
Este paso lo uso bastante fuera del workshop también. Tener tus datos expuestos como MCP te deja una herramienta de desarrollo muy útil: un Toolbox con queries de solo lectura contra la base (incluso de producción, con los recaudos del caso) para revisar el estado de algo o investigar un error desde el mismo CLI que ya usás para programar.
El agente con ADK
Después vino el agente propio. adk create te arma la estructura con un .env, un __init__.py y el agent.py. El agente generado es lo más simple que hay: un modelo, un nombre y un prompt genérico.
Primero lo corrimos sin tools, a propósito. Le preguntás por hoteles en Mendoza y te contesta algo genérico o directamente inventado, que va a cambiar según el modelo que uses. Esa respuesta es la que justifica todo lo que viene después.
Conectarlo al Toolbox son tres líneas: instanciar ToolboxSyncClient, cargar el toolset por nombre (el mismo my_first_toolset del YAML) y pasárselo al Agent. Si tenés diez toolsets, cada agente carga el que necesita.
Con adk web se ve la traza completa: qué tool eligió el modelo, con qué parámetros y qué devolvió.
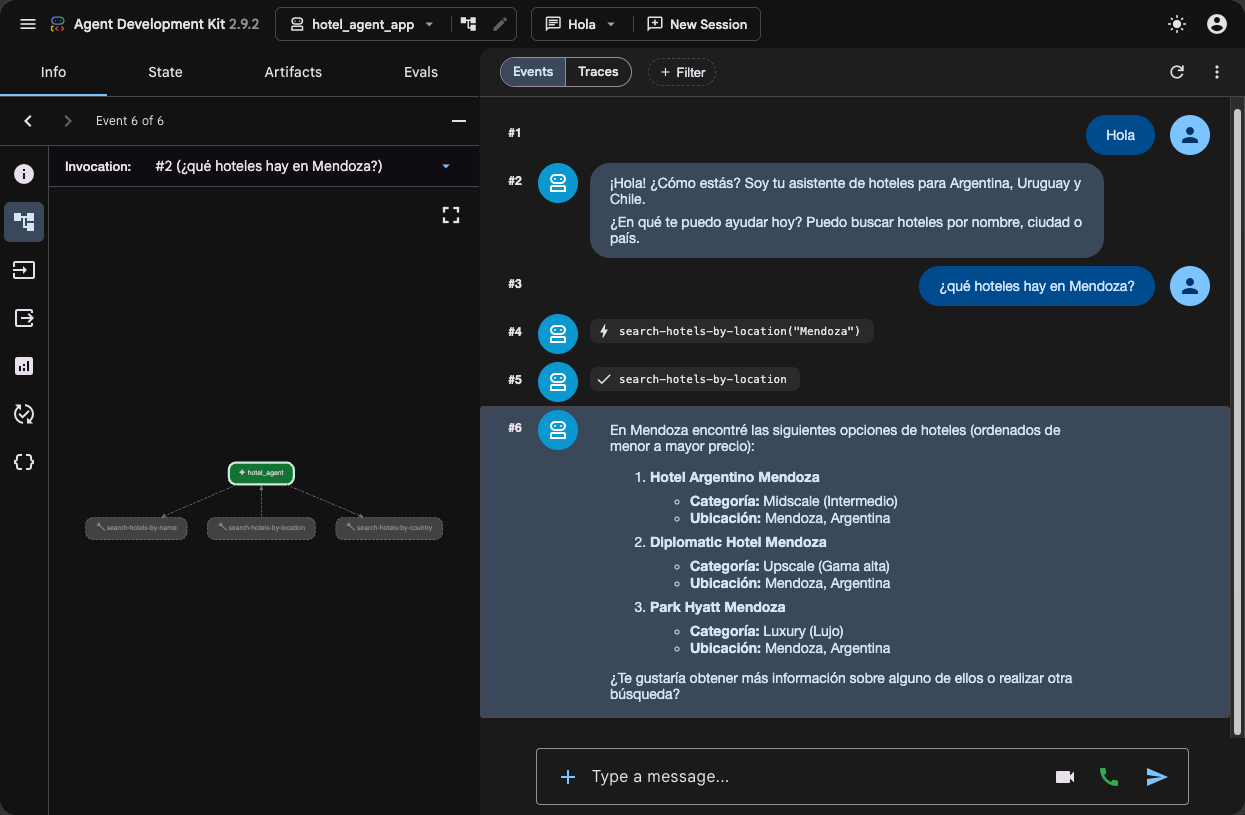
Fijate el orden: Midscale, Upscale, Luxury. Eso sale del ORDER BY del YAML, el modelo no tocó nada. Como el resultado ya viene ordenado, cuando le preguntás "¿cuál es el más barato de Buenos Aires?" el modelo trabaja sobre pocos datos y confiables. Y si le preguntás por Tokio, te dice que no tiene datos en vez de inventar; para eso está el "never invent hotels" en la instrucción.
La demo que más me gusta para cerrar esta parte dura un minuto: cambiás el ORDER BY en el tools.yaml para invertir el orden, reiniciás solo el Toolbox, y volvés a preguntar al agente, que no se tocó. El resultado cambia. Eso es lo que la documentación llama control plane para tus tools.
Lo que se rompió preparándolo
Por tiempos, el deploy a Cloud Run lo pasé rápido en las slides. Pero preparando el workshop fue donde más aprendí, y la mitad del repo es un troubleshooting con ocho problemas reales, cada uno con su causa verificada. Los tres más jugosos:
gemini-3.5-flash solo existe en la location global. adk create te pregunta la región, vos ponés us-central1 porque ahí está todo lo demás, y el agente arranca perfecto... hasta el primer mensaje, que devuelve 404 NOT_FOUND: Publisher model ... was not found. Hay que separar dos conceptos que el codelab original mezclaba: la región donde corre tu infraestructura (Cloud SQL, Cloud Run) y la location del endpoint del modelo.
En Cloud Run, la location vuelve a us-central1. Local funciona con global en el .env, deployás y aparece el mismo 404. El Dockerfile que genera adk deploy cloud_run escribe ENV GOOGLE_CLOUD_LOCATION=<region>, pisando lo que tenías. La solución que viaja con el código es forzarla al principio del agent.py:
import os

# El Dockerfile generado por ADK la pisa con la región de Cloud Run
os.environ['GOOGLE_CLOUD_LOCATION'] = 'global'
Asignación directa, no setdefault, porque la variable ya viene seteada. Funciona porque el cliente de google-genai se construye recién en la primera request. Desde ADK 2.9.0 también podés pasarla con --env en el deploy, y yo hago las dos cosas: explícito es mejor.
adk web en Cloud Shell: página en blanco. El HTML y el CSS dan 200 y todos los .js dan 403. ADK 2.x agregó un middleware anti DNS-rebinding que valida el header Origin, y el Web Preview de Cloud Shell sirve desde un dominio que no es loopback. ¿Por qué solo los .js? Porque la UI carga con <script type="module">, y los módulos ES siempre se piden en modo CORS, con Origin. Los <link rel="stylesheet"> e <img> van en modo no-cors, sin ese header, y el middleware los deja pasar. La solución en Cloud Shell es adk web --allow_origins '*', entendiendo que estás apagando esa protección en un server de desarrollo.
Este último me encantó: un problema de web platform de toda la vida metido adentro de una herramienta de IA. Si no sabés cuándo el navegador manda Origin y cuándo no, te podés pasar una tarde entera mirando esos 403.
Lo que me llevo
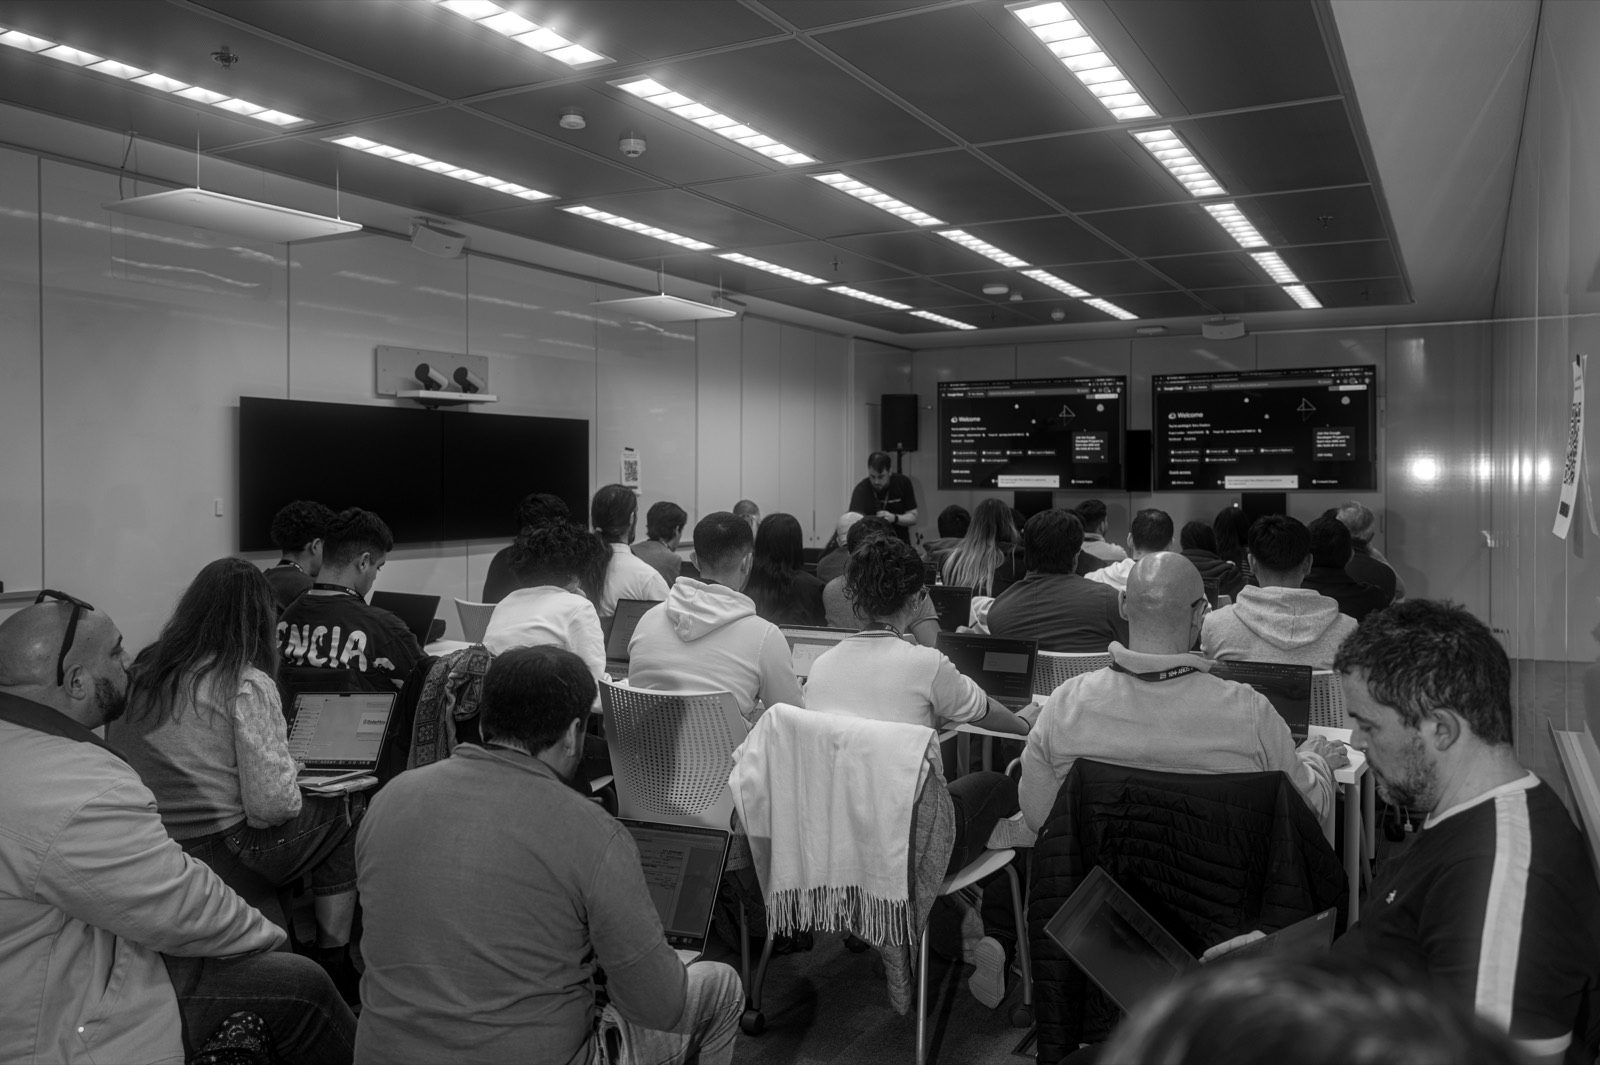
Dar un workshop en vivo, con una sala llena y gente online, siempre tiene su cuota de caos: la consola de Cloud Shell que se desconecta, la instancia de Cloud SQL que tarda cinco minutos (que aproveché para explicar MCP), algún vim que se pone rebelde con el pegado. Gracias a quienes estuvieron ayudando en la sala y en el chat, que hicieron que nadie quedara trabado.
Si tuviera que resumirlo en un par de líneas: el tools.yaml es el contrato (cambiás una query y no redeployás ningún agente), las description de las tools son donde más rinde invertir tiempo, y todo lo que se pueda resolver en SQL conviene resolverlo ahí y no en el modelo. Las credenciales, de paso, nunca pasan por el agente.
Si querés seguir, en el cierre del workshop dejé algunos ejercicios: una tool que filtre por disponibilidad con booked y las fechas, otra que escriba para reservar un hotel (y ahí aparecen los temas interesantes de permisos, confirmación e idempotencia), y usar authServices para que la tool conozca la identidad del usuario final. Si preferís TypeScript, en la serie sobre Google ADK está el mismo framework desde otro ángulo, y las FAQ del repo tienen la tabla de equivalencias para hacer el workshop en TypeScript, Go, Java o Kotlin.
Y si lo hacés y algo no funciona como está escrito, abrí un issue. La idea es que el material se mantenga al día, porque en este ecosistema lo que funcionaba hace tres meses ya no funciona.